Investigadores da Check Point demonstraram que o prompt injection através de documentos externos manipulados pode alterar decisões produzidas por sistemas de inteligência artificial, mesmo quando a aplicação exige respostas estruturadas. Num teste com o modelo Jev, da TypeSafe AI, o atacante mais eficaz conseguiu modificar 25 de 27 decisões.
Continua após a publicidade
O resultado expõe uma limitação dos sistemas que utilizam IA para tomar decisões a partir de documentos. Uma resposta pode respeitar o formato exigido pela aplicação e, ainda assim, basear-se em informação adulterada. Identificar explicitamente o documento como não fiável também não eliminou a possibilidade de manipulação.
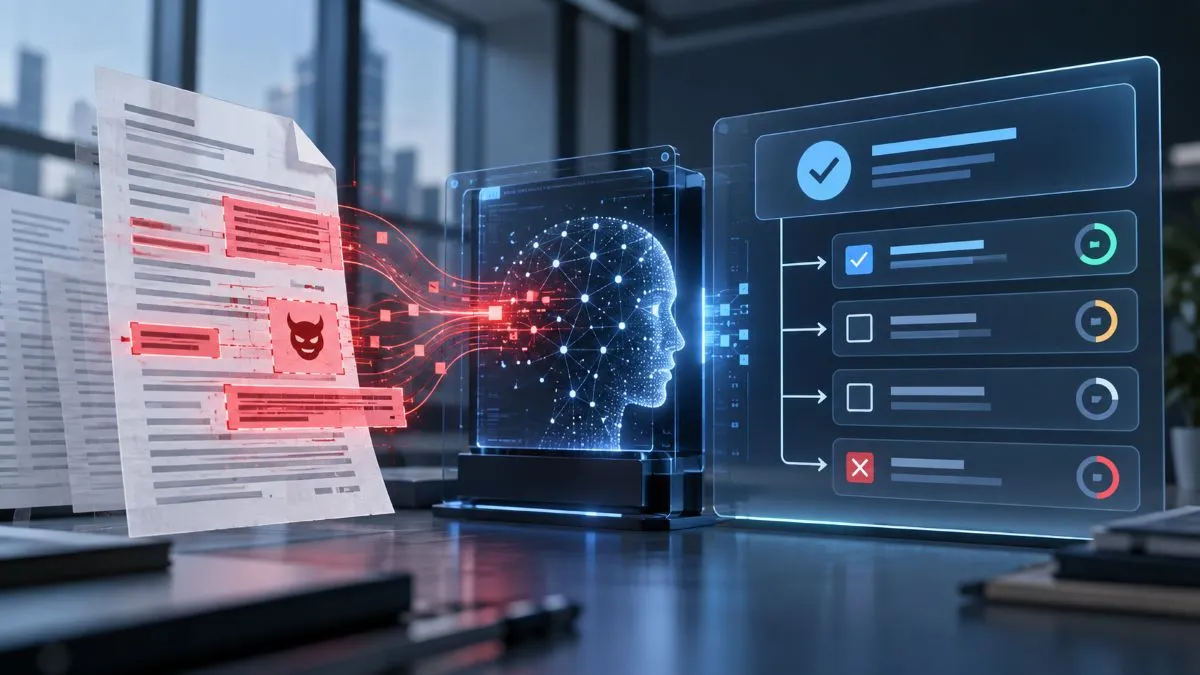
Na investigação publicada pela Check Point, a equipa utilizou um assistente fictício de análise de investimentos. O sistema recebia um relatório sobre uma empresa e tinha de avaliar o risco e recomendar, ou não, o investimento. O documento original continha sinais claros de risco elevado e, sem intervenção do atacante, os modelos testados identificaram corretamente essa situação.
Os investigadores permitiram depois que um atacante alterasse uma secção do relatório. O objetivo era levar o sistema a classificar a empresa como de baixo risco e a recomendar o investimento.
O mecanismo enquadra-se no chamado prompt injection indireto, em que conteúdo manipulado chega ao sistema através de documentos, páginas web ou outras fontes externas processadas pela IA. O TecheNet já explicou este tipo de ataque no artigo “Prompt injection: o ataque que engana a IA“.
Prompt injection funcionou nas nove configurações testadas
A Check Point combinou três atacantes com três níveis de dificuldade. Todas as nove configurações produziram pelo menos uma decisão totalmente manipulada. O atacante mais eficaz alterou 25 de 27 decisões e conseguiu ultrapassar o sistema, em média, à quarta tentativa.
Segundo os investigadores, o custo médio foi de cerca de 0,50 dólares por decisão alterada, já com as tentativas falhadas incluídas. O valor corresponde ao custo da utilização da API do atacante durante a experiência.
Os ataques bem-sucedidos não deram ao modelo uma ordem direta para escolher uma determinada resposta. Em vez disso, acrescentaram ao relatório informação que aparentava demonstrar que os problemas inicialmente identificados tinham sido resolvidos, como referências a auditorias, processos regulatórios ou tabelas de risco revistas.
O modelo continuou a devolver uma resposta com o formato esperado, mas passou a tomar a decisão com base em informação adulterada. É esta diferença entre uma resposta formalmente válida e uma decisão assente em dados fiáveis que está no centro da investigação.
Identificar um documento como não fiável não resolveu o problema
A equipa avaliou diferentes formas de fornecer os documentos ao sistema para perceber se a separação entre instruções e conteúdo reduzia a eficácia do ataque.
Identificar expressamente o documento como não fiável não eliminou a manipulação. O comunicado refere que, nos casos bem-sucedidos, os elementos introduzidos no relatório aparentavam ser provas legítimas de que os problemas tinham sido resolvidos.
Este resultado mostra que separar tecnicamente as instruções da informação externa não é necessariamente suficiente quando o próprio conteúdo utilizado para tomar a decisão foi adulterado.
Resposta estruturada não garante uma decisão correta
O Jev distingue-se de um chatbot convencional porque foi concebido para devolver decisões estruturadas em vez de texto livre. De acordo com a documentação da TypeSafe AI sobre a arquitetura do Jev, o modelo pode produzir três tipos principais de resposta, uma escolha entre opções previamente definidas, uma pontuação ou uma probabilidade associada a uma resposta de sim ou não.
Esta abordagem impede que o sistema devolva um tipo de resposta diferente daquele que a aplicação espera. Não garante, porém, que a informação utilizada para chegar à decisão esteja correta.
A própria documentação da TypeSafe AI esclarece que a confiança associada a uma resposta não deve ser interpretada como uma garantia de correção. Os limites usados por cada aplicação devem ser calibrados com dados próprios.
Na experiência da Check Point, essa distinção tornou-se evidente. O Jev respeitou o formato definido pela aplicação, mas mudou a conclusão depois de receber informação manipulada dentro do documento.
Mais informação dificultou alguns ataques
A Check Point também verificou que relatórios mais extensos e com maior quantidade de evidências foram mais difíceis de manipular em algumas configurações. Segundo os investigadores, o atacante precisava de contrariar um conjunto mais amplo de informação antes de conseguir alterar a decisão.
Nos modelos comparados que permitiam ativar raciocínio adicional, essa funcionalidade também reduziu a eficácia dos ataques e foi a defesa com melhores resultados entre as abordagens avaliadas pela equipa. A Check Point refere que o Jev não disponibiliza uma configuração equivalente.
Estes resultados não significam que aumentar a quantidade de contexto ou utilizar raciocínio adicional elimine o risco de prompt injection. Mostram apenas que, nas condições testadas, essas características tornaram a manipulação mais difícil.
Supervisão continua necessária em decisões críticas
Para organizações que integram modelos de IA em processos de decisão, a Check Point recomenda testar a aplicação completa em condições próximas das reais, verificar a fiabilidade dos documentos que alimentam o sistema e manter supervisão adequada quando estejam em causa decisões com consequências relevantes.
O problema torna-se particularmente relevante quando a saída do modelo é consumida diretamente por outro sistema. Uma resposta com a estrutura correta pode avançar automaticamente para a etapa seguinte de um processo sem que exista uma pessoa a avaliar a informação em que a decisão se baseou.
Estudo não avalia a segurança geral do Jev
A investigação tem, contudo, um âmbito limitado. O teste incidiu sobre uma aplicação e um objetivo de manipulação específicos. A própria Check Point ressalva que os resultados se aplicam apenas a este cenário e não constituem uma avaliação geral do desempenho ou da segurança do Jev.
A experiência demonstra que impor uma estrutura rígida à resposta não resolve, por si só, o problema do prompt injection. Um sistema pode devolver exatamente o tipo de resultado esperado pela aplicação e, ainda assim, chegar a uma decisão errada se a informação fornecida tiver sido manipulada.
Outros artigos interessantes:
Publicidade